A mesterséges intelligencia már nemcsak tartalmat ír és válaszokat ad, hanem egyre aktívabban olvassa is a webet. A ChatGPT, a Perplexity, a Claude és más AI-rendszerek mögött különböző automatizált botok járják végig az oldalakat: van, amelyik modellek tanításához gyűjt adatot, van, amelyik egy konkrét felhasználói kérésre nyit meg egy oldalt, és van, amelyik azért keres forrásokat, hogy az AI válaszában hivatkozással jelenjen meg egy cikk.
Ez már üzleti kérdés is. Egy kiadó számára ugyanis nem mindegy, hogy a tartalmát egy modell betanítására használják fel, vagy egy AI-kereső úgy idézi, hogy közben olvasót is küld vissza az oldalra.
Egy friss magyar kutatás szerint azonban a hazai híroldalak jelentős része ezt a különbséget egyelőre nem jeleníti meg nyilvánosan.
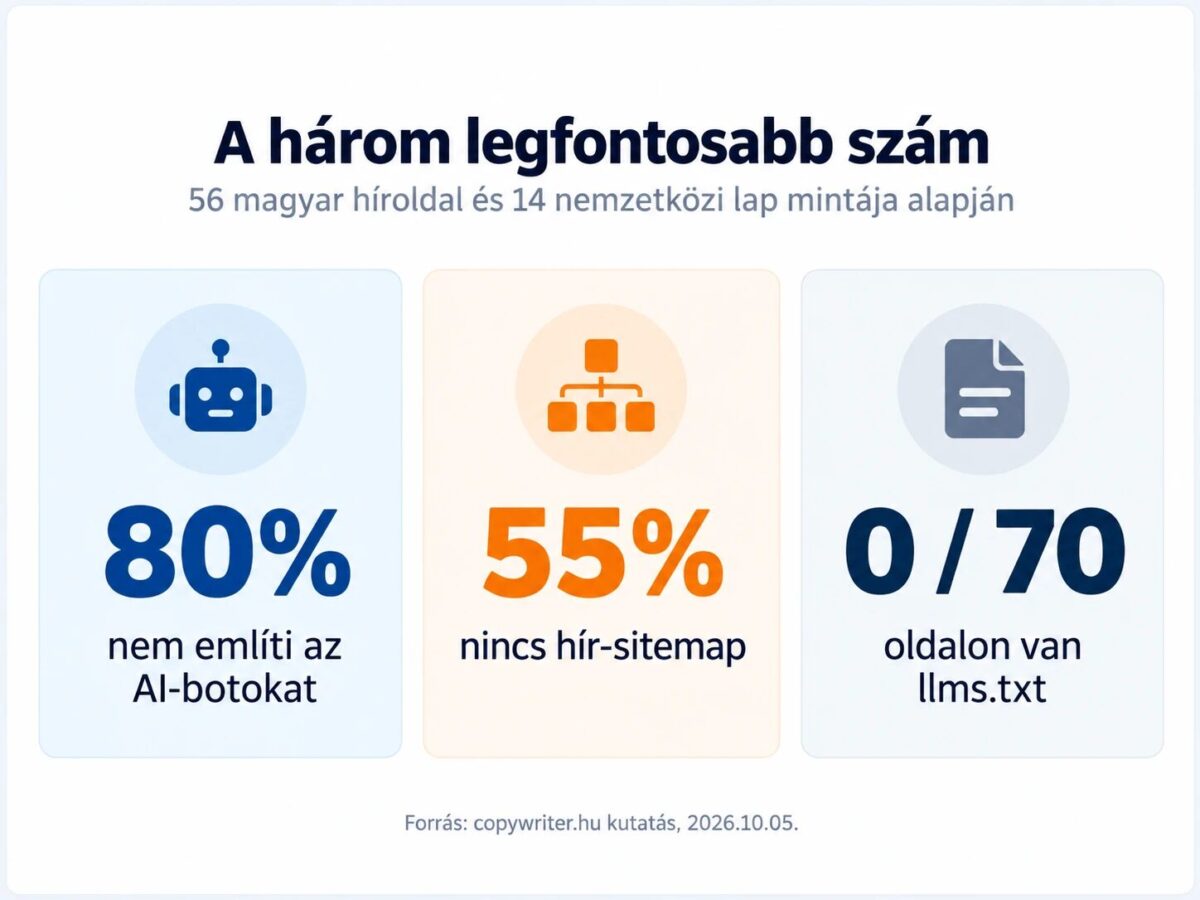
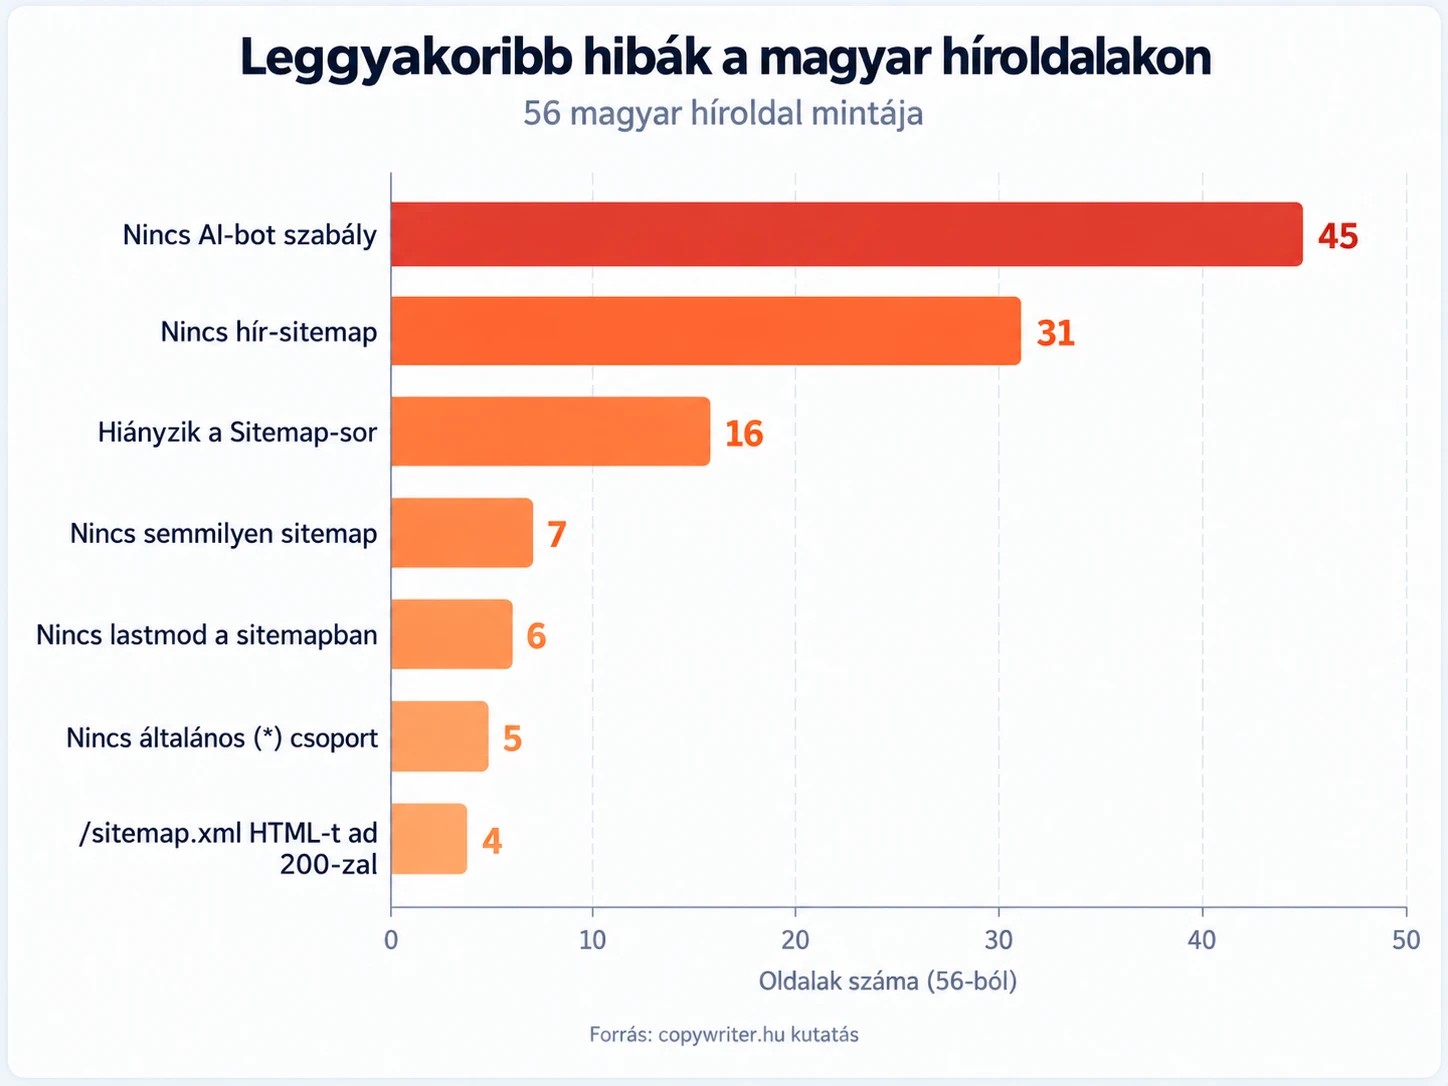
A Copywriter digital 56 magyar híroldal és 14 nagy nemzetközi lap robots.txt fájlját, sitemapjeit és llms.txt használatát vizsgálta meg. Az eredmény látványos: az 56 magyar híroldal közül 45 esetében nem találtak egyetlen, név szerint megadott AI-botra vonatkozó szabályt sem. A 14 vizsgált nagy nemzetközi lap közül viszont mind a 14 külön szabályozta valamelyik AI-crawler hozzáférését.
Ez azt jelenti, hogy a magyar minta nagyjából 80 százaléka a robots.txt szintjén jelenleg nem tesz különbséget az AI-rendszerek eltérő felhasználási módjai között.
Nem ugyanaz, ha tanul belőle az AI, és ha forrásként idézi
Az „AI-bot” valójában gyűjtőfogalom. Egy kiadó szempontjából legalább három különböző helyzetet érdemes megkülönböztetni.
Az egyik a modellfejlesztési célú bejárás. Ilyenkor egy bot nagy mennyiségű nyilvános webes tartalmat olvas végig, hogy azt később egy nyelvi modell fejlesztéséhez használják fel.
A második a közvetlen felhasználói lekérés. Ebben az esetben egy ember konkrétan egy adott oldal tartalmát szeretné megnyitni vagy feldolgoztatni egy AI-rendszerrel.
A harmadik az AI-alapú keresés és forrásmegjelölés. Ilyenkor a rendszer azért térképez fel weboldalakat, hogy a válaszában forrást tudjon idézni, és adott esetben kattintható linket is adjon.
Üzleti szempontból ez a három helyzet nagyon különböző.
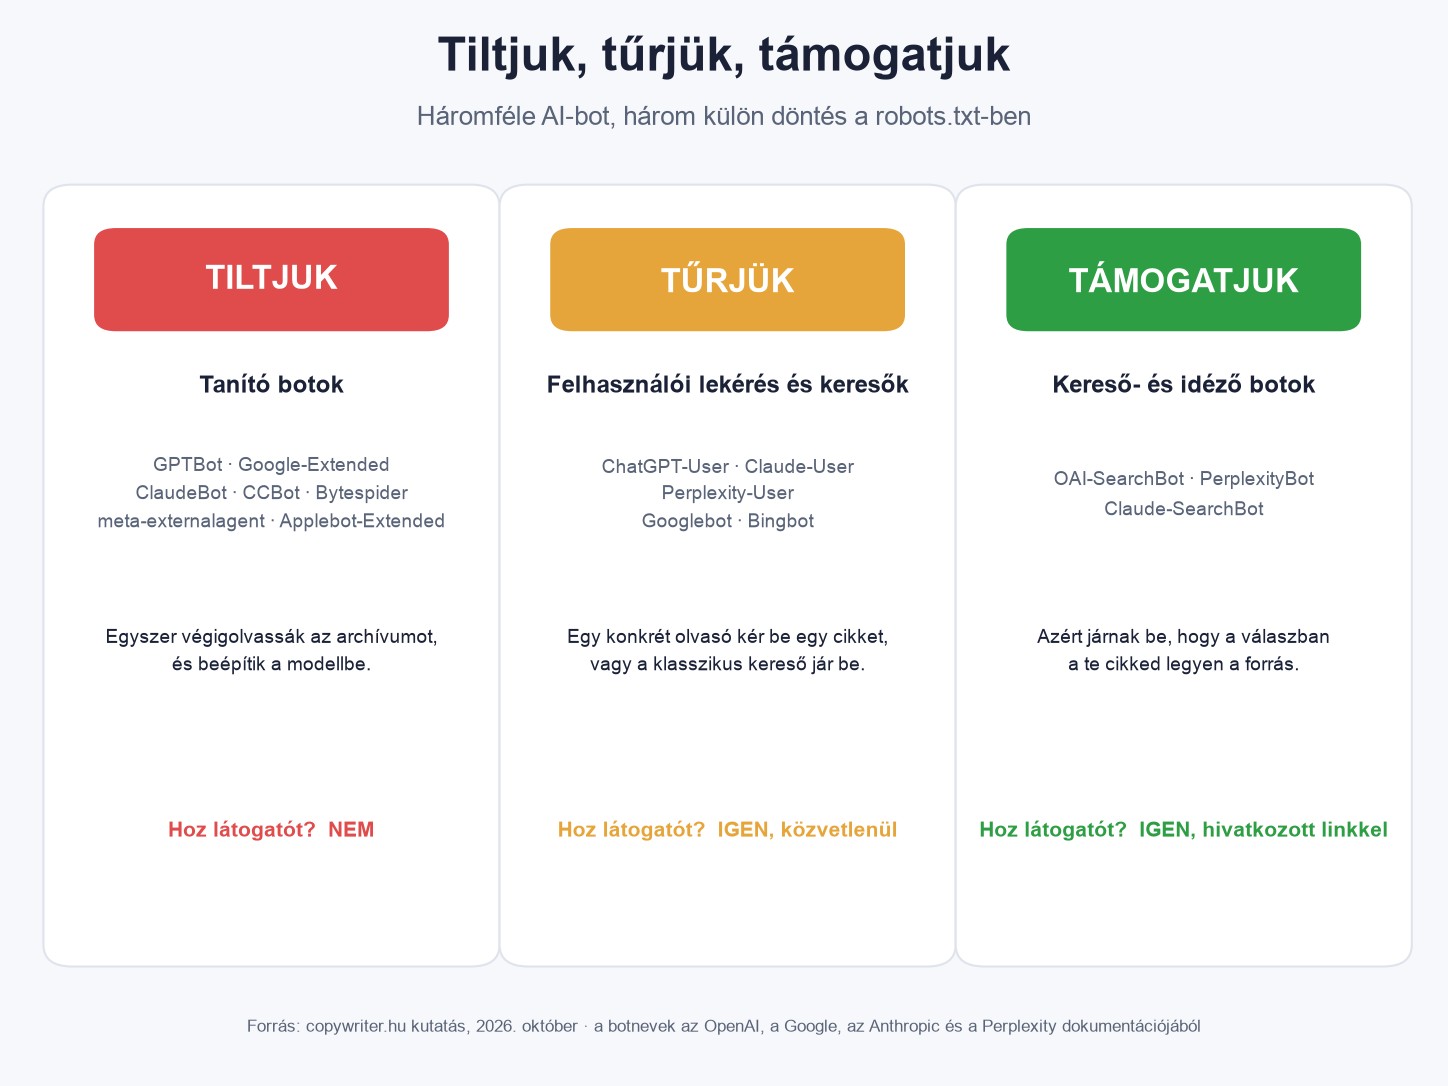
Egy kiadó dönthet úgy, hogy nem szeretné, ha a tartalma modellek tanítására szolgálna, ugyanakkor érdekelt lehet abban, hogy AI-keresők forrásként hivatkozzanak rá. Ha azonban minden AI-botot egyformán kezel, vagy egyikről sem rendelkezik, ezt a különbséget nem használja ki.
A kutatás ezt a gondolkodást a „tiltjuk, tűrjük, támogatjuk” modellben foglalja össze. A modellfejlesztési célú botokat egy kiadó korlátozhatja, a közvetlen felhasználói hozzáférést engedheti, az AI-keresési és idézési funkciókat pedig akár kifejezetten támogathatja.
Nem arról van szó, hogy minden kiadónak ugyanazt a konfigurációt kellene választania. A lényeg inkább az, hogy megszülessen a döntés.
A nemzetközi lapok már döntöttek
A vizsgált nemzetközi oldalak között ott volt többek között a New York Times, a Guardian, a BBC, a Financial Times, a Reuters, a Washington Post, a Spiegel, a Le Monde és az El País.
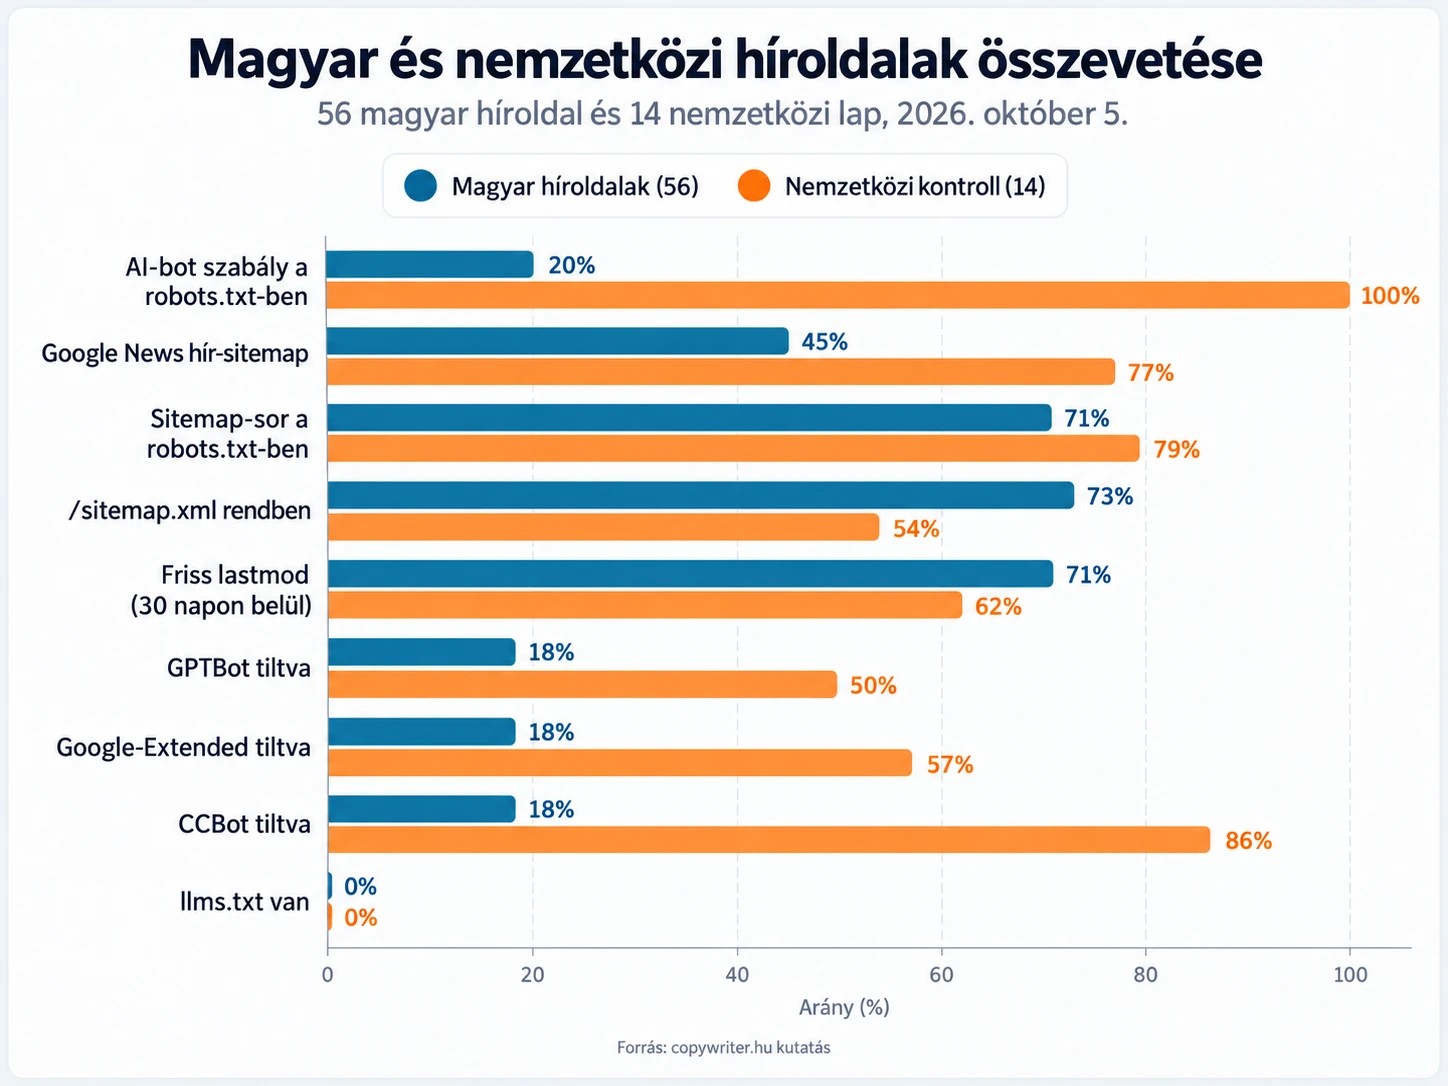
A kutatás szerint mindegyikük külön kezeli legalább az AI-botok egy részét, de nem ugyanúgy.
Van, amelyik széles körben tiltja őket, más szelektíven enged bizonyos hozzáféréseket. Ez önmagában is fontos jelzés: az AI-crawlerek kezelése már nem egyszerű technikai webmesteri kérdés, hanem üzleti, jogi és tartalomstratégiai döntés.
Egy médiacégnek ma már arról is döntenie kell, hogy milyen feltételek mellett szeretne részt venni az AI-alapú információs ökoszisztémában.
A klasszikus SEO alapjai közben sok helyen rendben vannak
A kutatás egyik érdekes tanulsága, hogy a magyar oldalak lemaradása nem feltétlenül technológiai.
A robots.txt fájl, a sitemap és más klasszikus SEO-elemek sok oldalon működnek. A problémát inkább az jelenti, hogy ezek a rendszerek még nem feltétlenül tükrözik az AI megjelenésével kialakult új üzleti helyzetet.
A vizsgált magyar híroldalak 55 százalékánál például nem találtak külön Google News hír-sitemapet sem. Ez már hagyományos keresőoptimalizálási kérdés: a hír-sitemap segítheti a friss cikkek gyorsabb felfedezését.
Az llms.txt fájl használata viszont szinte egyáltalán nem terjedt el. A teljes, 70 oldalas mintában egyetlen ilyen fájlt sem találtak. Ez különösen érdekes annak fényében, hogy az elmúlt időszakban több AI-SEO tanácsban is előkerült, mint lehetséges optimalizálási eszköz.
Az AI-forgalom még kicsi, de a stratégiailag fontos
A kiadók számára ma még a Google és a közösségi platformok adják a forgalom döntő részét. Az AI-keresőkből érkező látogatások aránya egyelőre ennél jóval kisebb.
A tendencia azonban egyértelmű: egyre több felhasználó nem hagyományos keresőben kezdi az információszerzést, hanem közvetlenül ChatGPT-től, Perplexitytől vagy más AI-alapú szolgáltatástól kér választ.
Ez új versenyhelyzetet teremt.
A kérdés már nemcsak az, hogy egy oldal hányadik helyen szerepel a Google-ben, hanem az is, hogy egy AI-rendszer melyik forrást idézi, kit nevez meg hiteles hivatkozásként, és melyik oldalra küld tovább kattintást.
Ebben a környezetben a robots.txt apró technikai fájlnak tűnhet, de mögötte valójában nagyobb stratégiai döntés áll.
A kiadóknak el kell dönteniük, hogy az AI-t elsősorban tartalomfelhasználási kockázatként, új forgalmi csatornaként vagy a kettő kombinációjaként kezelik.
A magyar médiapiacon ez a döntés sok esetben még nem látszik nyilvánosan. A nagy nemzetközi kiadóknál viszont már igen.
A teljes kutatás, a 70 vizsgált oldal név szerinti összehasonlítása és az AI-botok részletes magyarázata a Copywriter.hu oldalán érhető el:
https://www.copywriter.hu/tiltjuk-turjuk-tamogatjuk-ai-magyar-media/